Бързо, евтино, качествено - избери две.
Всеки, който е работил в бизнеса, знае това правило. На 22 септември 2026 г. Claude Opus 5.5 го наруши.
Anthropic описват новия модел с едно изречение: работи на нивото на Fable 5.1 при повечето задачи, а струва с 40% по-малко от Opus 5. Fable 5.1 е най-силният им модел. Досега беше и най-скъпият начин да свършите сложна работа.
Какво точно излезе
- Име в API:
claude-opus-5-5, наличен в Claude.ai, Claude Code и API-то от първия ден. - Цена: 4 $ за милион входни и 20 $ за милион изходни токена (при Opus 5 бяха 5 $ и 25 $). Кешираното четене струва 0,20 $, а batch режимът дава още 50% отстъпка.
- Контекст: 1 милион токена на вход, до 128 хиляди на изход.
- Скорост: над 30% по-бърз от предшественика си.
- Мисленето е винаги включено. Не може да се изключи, а нивото на усилие по подразбиране е
medium.
Последната точка ще усетят разработчиците. Кодът, който изключва мисленето или налага конкретен инструмент (forced tool_choice), трябва да се пренапише.
Официалните тестове
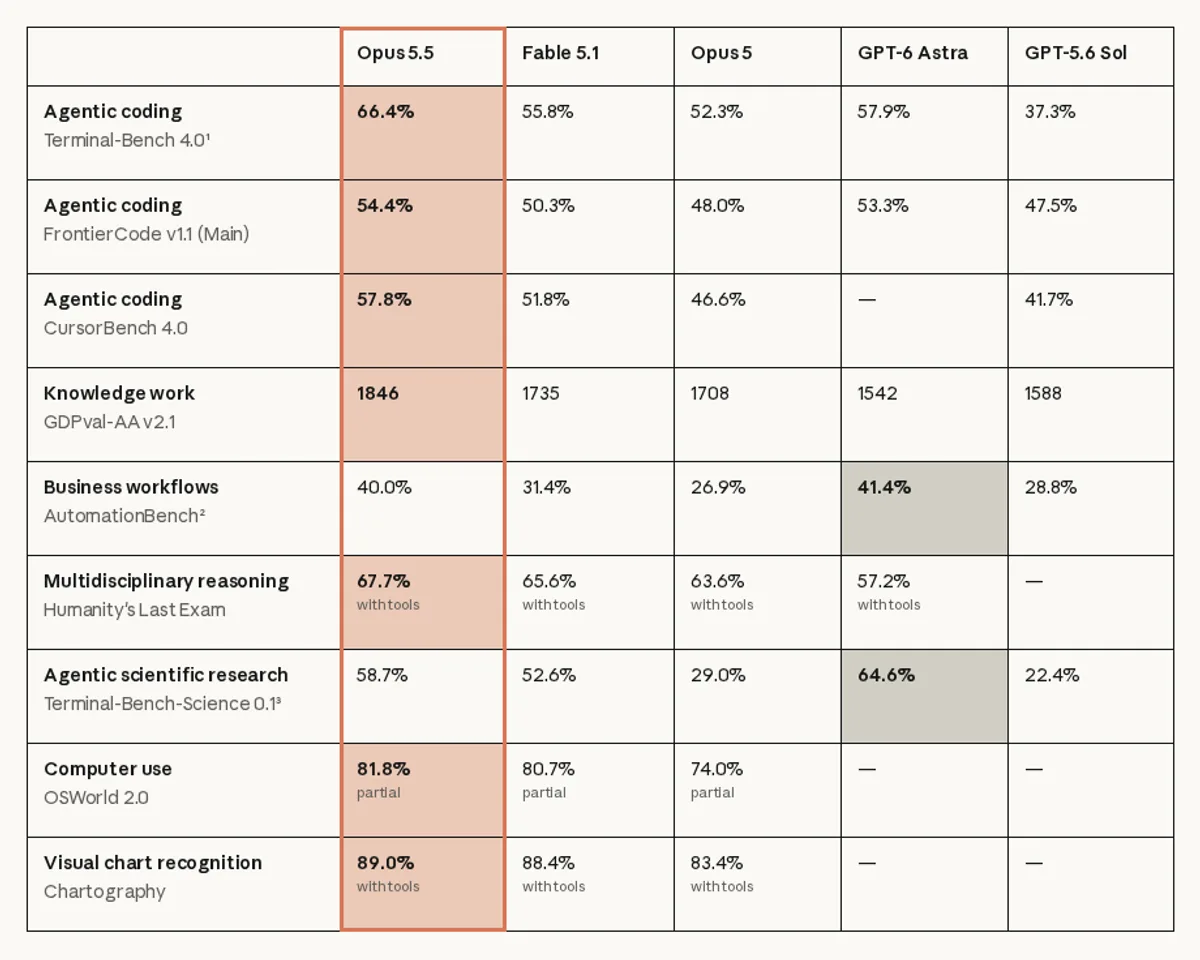
Това е таблицата от обявата на Anthropic. Оцветената колона е Opus 5.5, сивите клетки са тестовете, в които печели конкурентът.
Източник: anthropic.com
Три реда си заслужават внимание:
- Terminal-Bench 4.0 (работа в терминал): 66,4% срещу 55,8% за Fable 5.1 и 57,9% за GPT-6 Astra. Голяма преднина, не статистически шум.
- GDPval (реални офис задачи): 1846 точки Elo срещу 1735 за Fable 5.1 и 1542 за Astra. Това е тестът, който ни интересува най-много - анализи, документи, таблици от реални професии.
- Където губи: GPT-6 Astra води при бизнес автоматизациите (AutomationBench) и научните изследвания. Opus 5.5 не печели всичко - и Anthropic сами го показват.
Тестовете са едно, реалната работа - друго. Anthropic дават два примера от ранни клиенти: миграция на код от 680 хиляди реда за под един ден и одит на кодова база от 200 хиляди реда за под 3 часа. Boris Cherny, създателят на Claude Code, пише, че с „няколко кратки промпта“ Opus 5.5 е формално проверил Claude Agent SDK и е отворил 16 заявки за поправка на бъгове.
Мнението на Иван Цукев, основател на Аула
Досега всеки нов модел идваше с уговорка. По-умен, но по-скъп. По-бърз, но по-глупав. Винаги някой компромис.
Този път няма.
Ползвам го от първия ден. Кратката ми оценка: по-бърз, по-евтин, по-умен. И много по-приятен за разговор.
За абонатите: лимитите на Pro, Max и Team се вдигат. Същият абонамент, повече работа. Дебатът дали планът за 20 € си заслужава току-що стана доста по-кратък.
Лимитите са потвърдени официално от Anthropic: петчасовите лимити на Pro, Max и Team се вдигат, а абонатите получават и еднократно нулиране на лимита, което сами решават кога да използват.
Има и четвърто нещо, което не беше в менюто.
Най-честата критика към Opus 5 беше, че пише много и трудно се следи. Умен, но като консултант, който таксува на страница.
5.5 казва най-важното в първото изречение. Спира, когато е казал достатъчно. Следва правилата ти за писане, без да ги забравя на третия отговор.
За пръв път разговорът тече като с колега, който знае кога да млъкне.
Капанът: „max“ не значи „по-добре“
Моделът има нива на усилие - колко дълго да мисли, преди да отговори. Логиката казва: най-високото ниво дава най-добър резултат. Официалните числа в таблицата горе са именно на max.
В реална работа картината е друга.
Simon Willison, един от най-внимателните тестери на AI модели, пусна Opus 5.5 на max и получи грешни отговори след по 20 минути мислене и 2,56 $ на опит. Изводът му: „max е на практика безполезен“. Въпреки това Opus 5.5 вече е моделът му по подразбиране - просто на по-ниско усилие.
Matthew Berman стигна до същото от друга посока. На FrontierCode нивото medium бие max при много по-ниска цена на задача. Неговата теза: вече не питаме кой модел е най-умен. Питаме колко струва една свършена задача.
Във видеото Thariq от екипа на Claude Code разказва как го ползват вътре в Anthropic: Opus 5.5 е моделът за всекидневна работа, а Fable 5.1 остава за планиране и проверки по сигурността. Когато новият модел е дошъл, екипът е изтрил част от системния prompt - моделът вече не се нуждаел от тези указания.
Кой модел за какво
- Opus 5.5 на
medium- за почти всичко: текстове, анализи, таблици, код. - Fable 5.1 - когато грешката е скъпа: стратегия, планиране, проверка на сигурността.
maxусилие - само ако сте пробвали по-ниското и не е стигнало. Иначе плащате за колебание.
Anthropic твърдят, че Opus 5.5 е и най-безопасният им модел досега - с най-добър резултат в поведенческия одит и защити на нивото на Fable 5.1. Независими тестери като METR са го проверявали преди пускането.
Тясното място вече не е моделът
Тясното място е човекът срещу него. Който не знае какво да го пита, не му дава контекст и още проверява дали „AI-ят не си измисля“ с въпрос за столицата на Франция.
Моделите поевтиняват всеки месец. Уменията на екипа - не.
Точно това учим в курса „Практически AI с Claude“: как да дадете на модела добра задача, контекст и как да проверите резултата. Ако тепърва започвате, AI Старт ви дава основата за няколко часа.
Бързо, евтино, качествено - избери две.
Правилото още важи. За фирмите, които чакат следващия модел, преди да започнат с този.

Коментари
Няма коментари още — бъди първи.